中科曙光ParaCache助力Token并发提升16倍
发布日期:2026-10-30
来源:快科技
10月30日消息,在10月29日于郑州举办的2026数据存储产业大会上,中科曙光展示了以“AI数据工厂”为核心的最新探索,推动存储从被动数据保存走向主动参与AI生产全流程,解决大模型推理中Token生成效率低下的核心痛点。
随着AI从生成迈入执行阶段,智能体长上下文和多轮交互需要持续访问与更新数据。数据供给不及时、计算结果难以复用,不仅增加响应延迟,也造成算力资源浪费。
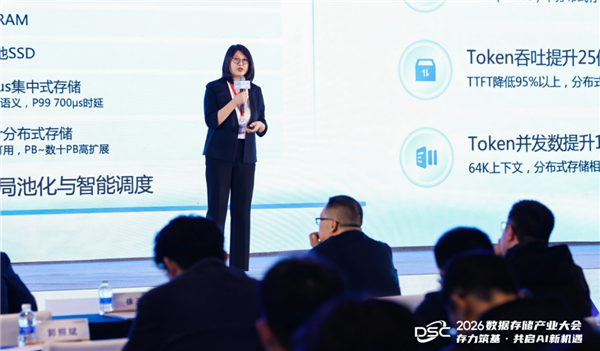
中科曙光分布式存储产品部总经理石静指出,存储的核心价值是持续向Agent提供可检索、可更新、可治理的记忆与上下文。
要让存储真正加速Token生成,先要解决数据分散与孤岛问题。中科曙光依托ParaStor分布式存储与FlashNexus集中式存储,通过统一命名空间和多协议访问实现海量异构数据的统一管理,并根据数据热度跨介质、跨平台调度,减少重复搬运。
在此之上,“存-算-传-用”全栈协同进一步压缩I/O路径。通过XDS数据直通、BurstBuffer本地缓存与scaleFabric高速网络协同优化,数据读取与模型计算得以并行开展,让GPU尽量不再空等数据。
推理环节的关键突破在于KV Cache的管理。ParaCache统一管理多级KV Cache并实现跨节点共享,减少重复计算。在64K上下文测试中,相较GPU纯计算方式,采用分布式存储的方案Token并发数提升16倍,首Token时延降低95%以上。
目前,曙光AI数据工厂方案已在多个场景落地验证。在国家超算互联网核心节点曙光8000系统中,数百PB级存储构建了统一数据底座。
在智元机器人数采工厂,百PB级对象存储与数十PB级全闪文件存储协同,支撑上千小时训练不间断;在自动驾驶领域,全闪与混闪统一资源池提供100PB以上可用空间。
从数据容器到AI数据工厂,存储的角色正在被重新定义。当Token生成的效率直接决定AI应用的成本与体验,让数据按需流动、让计算结果持续复用,正在成为算力之外的另一条提速路径。